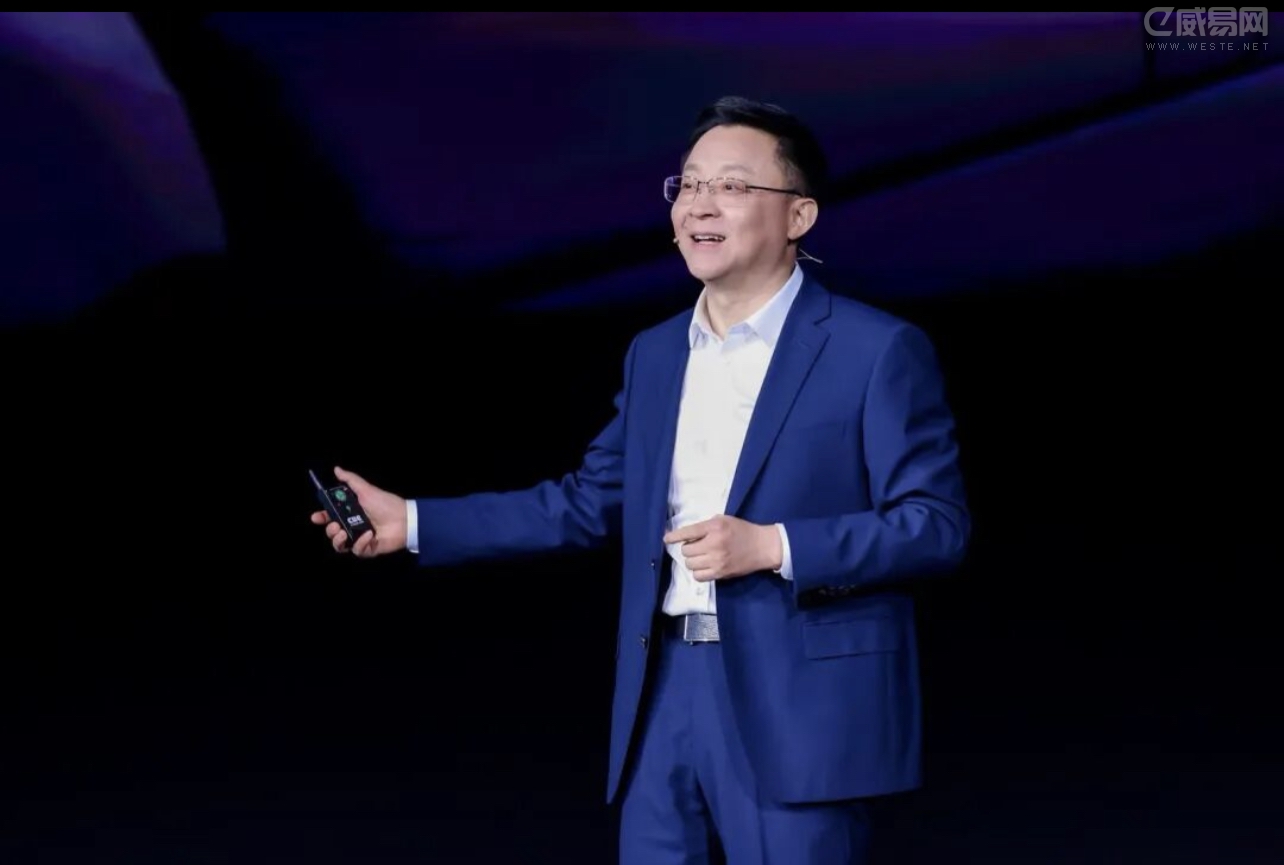
10月22日,2026科大讯飞全球1024开发者节在北京国家会议中心二期举行。科大讯飞董事长刘庆峰在约两个小时的主论坛演讲后,围绕国产算力、端云协同、商业化落地和AI治理接受了媒体群访。
他的表述非常直接:国产算力仍有差距,但必须在国产平台上完成训练;大模型不能只停留在个人提效,必须嵌入企业流程;而AI带来的就业冲击,可能比“模型失控”更紧迫。
国产算力:差距仍在,但必须做训练
刘庆峰承认,当前国产算力与国际顶尖水平仍有接近两代差距,尤其是单卡算力、显存带宽和训练生态仍不完善。很多厂商目前更多是在国产算力上做推理,真正在国产平台上完成完整预训练的不多。
但他强调:“只有真正地在国产算力上训练出自己的模型,才是真的自主可控。”在他看来,全栈自主可控至少包括四层:算力必须能完成训练,算法必须持续创新,数据必须能自主获取和清洗,还要具备面向场景的软硬一体化能力。
讯飞此次发布的端云一体讯飞星火X2.6,正是这一路线的最新版本。它首次基于全国产算力完成超长上下文代码与智能体任务训练,训练效率提升约4倍,推理效率提升约4.5倍。刘庆峰预测,随着国产芯片和生态进步,这一差距有望在未来两年拉平。
他呼吁更多厂商加入国产算力训练生态。“我们并不希望讯飞是唯一在国产算力上做训练的。”他说,适配成本高,如果更多企业一起投入,才能分摊沉没成本,避免动辄几十亿、上百亿的无效投入。
端云协同:60%留在端侧,解决“怕泄密、怕太贵”
刘庆峰把大模型落地中的矛盾概括为两件事:企业怕数据泄露,也怕Token成本太高。他的解法是端云一体:不是把云端模型无限做大,而是让端侧承担更多日常任务,云端只处理最复杂的问题。
按照他的规划,未来约60%的应用可以在本地端侧完成,数据不出端,推理成本为零;30%通过端云协同完成;剩下10%交给云端大模型处理。讯飞新发布的端云路由准确率已达到96.1%,系统会根据任务难度、设备能力和数据安全需求,自动分配执行路径。
这也解释了讯飞为何同时发布4B端侧模型。刘庆峰认为,端侧小模型不能脱离强云端基座,必须通过云指导端、端云联合训练,才能既安全又具备持续迭代能力。
商业化:优选G端,做深B端,做强C端
谈到讯飞当前业务阶段,刘庆峰没有用“全面爆发”这样的表述。他认为,底座模型仍处于快速探索阶段,但教育等场景已从0到1走向1到10。
后续策略是“优选G端、做深B端、做强C端”。G端优先选择付费能力明确、价值清晰的场景;B端通过讯飞星帆WinWork数字员工平台,把大模型嵌入风控、合同审查、采购寻源、商机评审等真实流程;C端则继续强化学习机、办公本、AI眼镜、AIPC等产品。
他还特别提到,AI目前更多带来个人提效,但企业级提效仍不足。WinWork的目标是让数字员工“读懂业务、嵌入流程、与真实员工协同”,从而把组织提效从20%以上提升到50%以上。
AI治理:比模型失控更迫切的是就业分流
在技术之外,刘庆峰也谈到了AI的社会影响。他认为,模型自我意识、失控风险值得研究,但目前更紧迫的问题是岗位被快速替代后的社会保障。
他估计,未来5到10年,社会所需的生产和服务可能只需要10%到20%的人完成。届时,劳动力分流、工作时长调整、新职业定义和社会保障体系都需要重新设计。这也是他今年两会建议的重点之一:建立社会兜底保障,缩短工作时长,重新定义工作的社会价值。
在刘庆峰的发言里,很少出现“遥遥领先”“颠覆一切”式的表达。他更愿意用“长跑”来形容人工智能发展,并多次提到要避免无效投入、控制资本开支。
这背后,既有科大讯飞作为老牌AI公司的谨慎,也有它对国产算力路线的现实判断:不回避差距,但坚持训练;不盲目堆参数,但要把端侧做透;不回避就业冲击,但主张用制度去承接。
对投资者而言,接下来值得继续跟踪科大讯飞的不只是星火X2.6的模型指标,还包括端云协同能否真正降低企业Token成本、WinWork在B端场景中的复购情况,以及国产算力生态是否如他所判断的那样在未来两年明显成熟。